
Set 是一堆不重複的字串,沒有順序。
SADD key member ...(加進去,回傳真的加進去幾個,重複的算 0)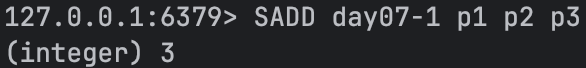
SMEMBERS key(全部撈出來)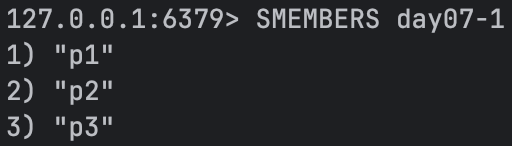
SISMEMBER key member(1 表示存在,0 表示不存在)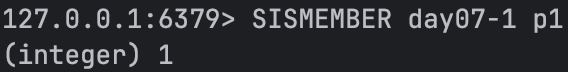
SCARD key(有幾個)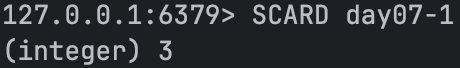
SREM key member ...(刪掉,回傳刪掉幾個)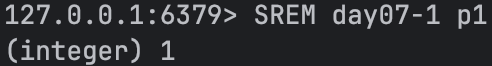
SINTER key ...(交集,每個集合裡都有的)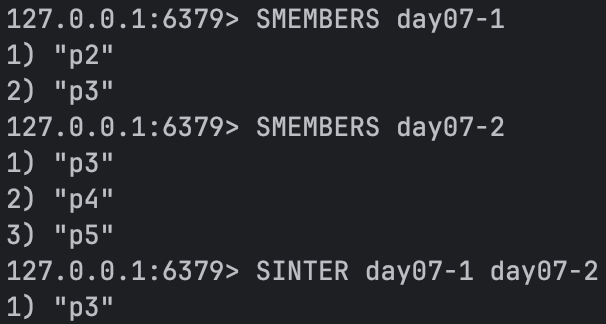
SUNION key ...(聯集,合起來自動去重)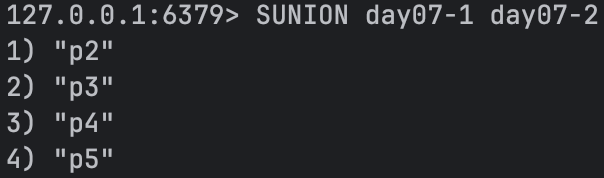
SDIFF key ...(差集,在第一個裡面但不在後面那些裡面的)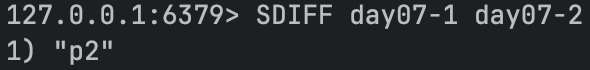
SPOP key count(隨機抽走 count 個,抽走就從集合裡消失)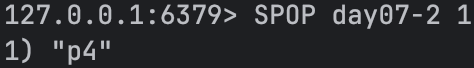
一個商品有很多標籤,一個標籤底下也有很多商品。存的時候反過來,用「標籤 → 商品集合」:
SADD tag:3C p1 p2 p3
SADD tag:sale p2 p3 p4
要找「同時是 3C 又特價」的商品,SQL 需要多開一張關聯表再 JOIN,這裡一個指令就好:
SINTER tag:3C tag:sale # p2 p3
多一個條件就多一個 key,指令本身不用改。另外兩個也很好用:
SUNION tag:3C tag:sale(3C 或特價,可以當推薦池)SDIFF seen:1 bought:1(看過但沒買的)Java 是用 SetOperations:
private final SetOperations<String, String> set;

public TagController(StringRedisTemplate redis) {
    this.set = redis.opsForSet();
}

/** 打標籤:同一件商品重複打同一個標籤,集合裡還是只有一筆 */
@PostMapping("/{productId}")
public Map<String, Object> tag(@PathVariable String productId, @RequestParam List<String> tags) {
    tags.forEach(tag -> set.add("tag:" + tag, productId));
    return Map.of("productId", productId, "tags", tags);
}

/** 同時有這些標籤的商品,一個 SINTER 做完 */
@GetMapping("/search")
public Set<String> search(@RequestParam List<String> tags) {
    return set.intersect(tags.stream().map(t -> "tag:" + t).toList());
}
先打四件商品的標籤,再篩「3C + 特價」:
curl -X POST "http://localhost:8080/tag/p1?tags=3C"
curl -X POST "http://localhost:8080/tag/p2?tags=3C,sale"
curl -X POST "http://localhost:8080/tag/p3?tags=3C,sale"
curl -X POST "http://localhost:8080/tag/p4?tags=sale"

curl "http://localhost:8080/tag/search?tags=3C,sale"
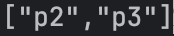
報名用 SADD,同一個人連按十次也只會有一筆。開獎用 SPOP:
SPOP lottery:1 3
一次抽 3 個,抽出來的會直接從集合裡移除,所以不可能抽到同一個人兩次,也不用另外記誰中過獎。
/** 抽獎:一次抽 count 個,抽出來的就從池子裡移除 */
@PostMapping("/draw")
public Map<String, Object> draw(@RequestParam long count) {
    List<String> winners = set.pop("lottery:1", count);
    return Map.of("winners", winners, "left", set.size("lottery:1"));
}
五個人報名:
curl -X POST "http://localhost:8080/lottery/join?user=u1" # u1 ~ u5 各打一次

再抽三個:
curl -X POST "http://localhost:8080/lottery/draw?count=3"

SINTER 看起來很好用,但資料量一大,背後的成本高。
假設有兩個各 50 萬件商品的標籤,Redis 算交集的方式很直覺:從其中一邊拿出第 1 個商品,去另一邊問「你有沒有這個」,再拿第 2 個去問,整整問完 50 萬次(Redis 會挑元素比較少的那一邊來走,所以看的是小的那個集合有多大)。
這會造成兩個問題:
SINTERCARD,專門只回傳數量,不用把幾十萬筆傳出去但光換成 SINTERCARD 沒有用,那 50 萬次比對還是得跑完,省下的只有傳回網路的時間。要加上 LIMIT 100,Redis 數到 100 筆就停手不再往下看,耗時才會從幾萬微秒掉到幾十微秒。
而且很多場景本來就不需要精確的數字:
LIMIT 100 回傳 100 就印 100+LIMIT 21 問一次就知道後面還有沒有,不用把幾萬筆的交集整包算完大集合取交集會卡住整台 Redis,只是要算數量的話一定要加 LIMIT。
相關範例程式碼可以參考 https://github.com/gary880306/redis-30days/tree/dev
| 型別 | 重點 | 用途 |
|---|---|---|
| String | 一個 key 對一個值 | 商品快取、INCR 計數器 |
| Hash | key 底下再掛一層 field | 購物車,HINCRBY 只改一項 |
| List | 有順序,兩頭都能進出 | 最近瀏覽、當 Queue |
| Set | 不重複、沒順序、能做集合運算 | 商品標籤、抽獎 |
選用的時候大致是這樣分:只改其中一個欄位就用 Hash,要照順序就用 List,不能重複或要取交集就用 Set。
排行榜要照銷量排,List 的順序是「誰先被推進去」,Set 根本沒有順序,兩個都對不上。繼續來看會自己照分數排序的 Sorted Set


 iThome鐵人賽
 看影片追技術